Top 10 der besten KI-Hardware-Hersteller in den USA 2026

Table of Contents
Das Rennen um den Aufbau der physischen Ebene der künstlichen Intelligenz ist zum folgenreichsten Wettbewerb in der amerikanischen Fertigungsindustrie geworden, und unsere Rangliste der Top 10 der besten KI-Hardware-Hersteller in den USA 2026 spiegelt wider, wie schnell sich das Kräfteverhältnis verschoben hat. Allein NVIDIA überschritt Anfang 2023 eine Marktbewertung von 1 Billion US-Dollar, und die darauf folgende Blackwell-Generation läuft nun 2,5-mal schneller und 25-mal energieeffizienter als ihre Vorgänger. Diese Zahlen erklären, warum Kapital weiterhin in amerikanische Fabs, Rack-Scale-Systeme und Programme für kundenspezifische Chips fließt.
Um diese Liste zu erstellen, haben wir mehrere Faktoren abgewogen, statt uns allein auf den Umsatz zu verlassen. Wir haben den Produktionsstatus betrachtet, denn ein ausgeliefertes Produkt wiegt schwerer als eine Roadmap-Folie. Wir haben offengelegte Kundenbestellungen, Benchmark-Ergebnisse aus unabhängigen Tests und die Tiefe des Software-Stacks jedes Unternehmens untersucht. Der Marktanteil bei KI-Beschleuniger-Rechenleistung war wichtig, aber ebenso die architektonische Differenzierung und die Frage, ob ein Hersteller Hardware auf dem offenen Markt verkauft oder intern verbraucht. Unternehmen, die Chips für ihre eigenen Rechenzentren entwerfen, rangieren niedriger als Merchant-Anbieter mit derselben technischen Fähigkeit, weil ihre Hardware nie Drittkäufer erreicht. Wir haben außerdem die Lieferzeiten für 2026, Änderungen in der Führungsebene und das Volumen verifizierbarer Bereitstellungen berücksichtigt, die im Laufe des Jahres angekündigt wurden. Das Ergebnis ist eine Rangliste, die Unternehmen belohnt, die Silizium in ausgelieferte Produkte verwandeln, nicht nur in Pressemitteilungen.
Die Top 10 der besten KI-Hardware-Hersteller in den USA 2026:
1. NVIDIA
NVIDIA wurde 1993 gegründet und hat seinen Hauptsitz in Santa Clara, Kalifornien. Das Unternehmen bleibt der Standard-Hardwarelieferant für nahezu jeden Trainingslauf großer Sprachmodelle und jede Inferenz-Workload in der Branche. Die Hopper-Architektur des Unternehmens, angeführt vom H100, und seine Blackwell-Reihe, einschließlich B200 und GB200, bilden die Standard-Compute-Ebene in Forschungslaboren, Cloud-Anbietern und Unternehmensbereitstellungen.
Der Software-Graben ist es, was NVIDIA von jedem Herausforderer auf dieser Liste unterscheidet. CUDA, die Parallel-Computing-Plattform des Unternehmens, bildet die Grundlage für nahezu die gesamte KI-Entwicklung und wird durch CUDA-X-Bibliotheken, NIM-Microservices und den NGC-Katalog vortrainierter Modelle und Container verstärkt. Wettbewerber können Transistorzahlen erreichen. Mehr als ein Jahrzehnt an Entwickler-Tooling zu replizieren, ist ein völlig anderes Problem.
Die Roadmap hat nicht an Tempo verloren. Der B300, auch Blackwell Ultra genannt, wurde in der zweiten Hälfte des Jahres 2025 ausgeliefert, und der Vera Rubin NVL72 Superchip ging im September 2026 in den frühen Kundenzugang. Vera Rubin kombiniert eine kundenspezifische Vera-CPU mit der Rubin-GPU und zielt auf ein Veröffentlichungsfenster Ende 2026. NVIDIA hält den dominierenden Anteil an KI-Beschleuniger-Rechenleistung, und kein anderes Unternehmen auf dieser Liste kommt an seine Kombination aus Hardware-Leistung und Software-Bindung heran.
2. AMD
Die Instinct MI400-Serie von AMD wurde auf dem Advancing AI 2026 vorgestellt, das vom 22. bis 23. Juli stattfand, und die Spezifikationen sind aggressiv. Der MI455X, basierend auf CDNA 5, verfügt über 320 Milliarden Transistoren, 432 GB HBM4-Speicher, 23,3 TB/s Spitzen-Speicherbandbreite und 40,3 PFLOPS OCP MXFP4-Rechenleistung. Der Chip wird in TSMC 2nm/3nm FinFET-Prozesstechnologie gefertigt, und der MI355X auf CDNA 4 wird bereits an Kunden ausgeliefert.
Die kommerzielle Zugkraft ist es, was AMD über jeden anderen NVIDIA-Herausforderer erhebt. Im September 2026 kündigte Hewlett Packard Enterprise eine Bestellung von Vultr über 1,2 Milliarden US-Dollar für Helios-Racks an, von denen jedes 72 MI455X-GPUs enthält und für US-Rechenzentren bestimmt ist. Das zählt zu den größten offengelegten Bereitstellungen von AMD-KI-Beschleunigern bis heute. Das Helios-Rack-Scale-System von AMD ging im Juli 2026 in die Vollproduktion, mit ersten Lieferungen, die für Ende Q3 2026 angestrebt werden.
AMD ist der einzige Merchant-Anbieter mit einer ausgelieferten GPU-Linie in Produktionsmaßstab, die mit der Rechenzentrums-Roadmap von NVIDIA Generation für Generation Schritt hält. Das Unternehmen liegt bei der Software-Reife noch zurück, aber eine Milliardendollar-Kundenbestellung beantwortet die Frage, ob Hyperscaler kaufen werden.
3. Intel
Intels Position stützt sich auf den größten bestehenden x86-Rechenzentrums-Fußabdruck der Welt und eine KI-Beschleuniger-Roadmap, die noch aufholt. Das Unternehmen stellte seine Nervana-Neuronalen-Netzwerk-Prozessoren ein und wechselte zu Habana Labs, das für 2 Milliarden US-Dollar übernommen wurde, um seine KI-Strategie zu verankern. Diese Entscheidung setzte Intels Zeitplan zurück und ließ das Unternehmen bei Trainings-Silizium im Hintertreffen.
Die Crescent Island Rechenzentrums-GPU, angekündigt im Oktober 2025 und auf der Xe3P-Architektur basierend, ist als inferenzfokussierter Beschleuniger positioniert. Kunden-Sampling ist für die zweite Hälfte des Jahres 2026 angestrebt, und Intel hat keine Trainingsfähigkeiten für das Teil offengelegt. Das Unternehmen verweist auch auf eine symbiotische Beziehung zwischen Fortschritten im Quantencomputing und Innovationen in der klassischen Verarbeitung, obwohl diese Arbeit weiter vom Umsatz entfernt ist.
Was Intel auf Platz drei hält, ist die Distribution. Kein anderes Unternehmen auf dieser Liste kann KI-nahes Silizium in so viele bestehende Enterprise-Server-Racks platzieren. Wenn Crescent Island in Inferenz-Workloads performt, hat Intel einen Kanal, der es aufnehmen kann. Die Hardware muss nur ankommen.
4. Google
Die Tensor Processing Units von Google repräsentieren das ausgereifteste von Hyperscalern entworfene KI-Silizium in Produktion. Die Ironwood-Generation, auch als TPU7x bezeichnet, erreichte im März 2026 die allgemeine Verfügbarkeit. Diese kundenspezifischen ASICs unterstützen sowohl Training als auch Inferenz über den gesamten KI-Lebenszyklus, einschließlich der mehrstufigen Reasoning-Workloads, die agentische KI-Systeme erfordern.
Google wurde 1998 gegründet und hat seinen Hauptsitz in Kalifornien unter CEO Sundar Pichai. Das Unternehmen entwirft seine TPUs gemeinsam mit offenen Software-Frameworks, was dem Unternehmen die volle Kontrolle über seinen technologischen Stack vom Chip-Layout bis zum bereitgestellten Modell gibt. Diese vertikale Integration erzeugt Effizienzgewinne, mit denen Merchant-Silizium-Anbieter kaum mithalten können, weil Google Hardware und Software gemeinsam auf seine eigenen Workloads abstimmt.
Die Einschränkung ist die Distribution. TPUs werden hauptsächlich über Google Cloud konsumiert und nicht als eigenständige Hardware verkauft, was den Rang des Unternehmens im Vergleich zu Merchant-Anbietern begrenzt. Für Kunden, die bereits in Google Cloud sind, bietet Ironwood jedoch eine glaubwürdige Alternative zur NVIDIA-Abhängigkeit.
5. Amazon (AWS)
AWS betreibt das vollständigste vertikal integrierte Custom-Silizium-Portfolio unter den Cloud-Anbietern, das Training, Inferenz und Allzweck-Computing umfasst. Der Trn3 UltraServer, veröffentlicht im Dezember 2025, enthält 144 Trainium3-Chips und leistet mehr als viermal besser als Trainium2 UltraServer. Trainium3 selbst ist 40 Prozent energieeffizienter als frühere Generationen, eine Zahl, die angesichts der Stromengpässe in Rechenzentren enorm wichtig ist.
Der Graviton4-Prozessor deckt die Allzweck-Seite ab. Dieser 96-Kern-ARM-basierte Chip treibt EC2 R8g-Instanzen für Datenbanken, Webserver und High-Performance-Computing-Workloads an und liefert bis zu 30 Prozent bessere Leistung mit dreimal so vielen vCPUs und dreimal so viel Speicher wie Graviton3. Trainium3 erreichte im Dezember 2025 die allgemeine Verfügbarkeit auf der NeuronCore-ASIC-Architektur.
AWS hält den größten Cloud-Marktanteil, was bedeutet, dass seine kundenspezifischen Chips in Volumina eingesetzt werden, die die meisten eigenständigen Chiphersteller nicht erreichen können. Dieses interne Volumen finanziert die kontinuierliche Entwicklung, und die Dichtegewinne im Trn3 UltraServer zeigen, dass die Strategie Ergebnisse liefert.
6. Qualcomm
Qualcomm ist später als seine Rivalen in den KI-Rechenzentrumsmarkt eingetreten, aber seine Effizienz-Benchmarks verlangen Aufmerksamkeit. Der Cloud AI 100 Chip erreichte in veröffentlichten Tests 227 Server-Abfragen pro Watt gegenüber 108 beim NVIDIA H100 und 3,8 Abfragen pro Watt gegenüber 2,4 beim H100 in Objekterkennungs-Workloads. Für Inferenz-Bereitstellungen, bei denen Strombudgets bindend sind, haben diese Verhältnisse echtes Gewicht.
Der AI200 Inferenz-Beschleuniger, angekündigt im Oktober 2025, zielt auf kommerzielle Verfügbarkeit im Jahr 2026. Qualcomm entwickelt auch ein ASIC-Design mit Near-Memory-Compute, einer Architektur, die den Datenbewegungs-Engpass reduziert, der konventionelle Beschleuniger einschränkt. Der Telekommunikations- und Mobilfunk-Hintergrund des Unternehmens verleiht ihm tiefe Expertise im Design strombegrenzter Chips, was sich direkt auf die Effizienzarbeit im Rechenzentrum überträgt.
Die Präsenz im Rechenzentrum ist noch früh, und Qualcomm hat keine großen Kundenbestellungen vergleichbar mit AMDs Vultr-Deal offengelegt. Die Effizienzgeschichte ist überzeugend. Die Bereitstellungsgeschichte wird noch geschrieben.
7. Apple
Apple geht einen anderen Weg als jedes andere Unternehmen hier. Statt Beschleuniger zu verkaufen, bettet es Neural Engines direkt in seine A-Serie und M-Serie Chips ein und kontrolliert den gesamten Stack vom Silizium-Design bis zu KI-Frameworks auf Betriebssystemebene. Diese vertikale Integration ermöglicht es Apple, KI-Funktionen auf iPhone, iPad und Mac bereitzustellen, ohne für die On-Device-Verarbeitung auf Drittanbieter-Silizium angewiesen zu sein.
Das Ergebnis ist End-to-End-Kontrolle über Leistung und Energieeffizienz in Consumer-KI-Hardware. Apple-Silizium wird in Volumina ausgeliefert, mit denen kein Rechenzentrums-Chiphersteller mithalten kann, was Apple zum größten Volumenversender von KI-fähigen Consumer-Prozessoren in den Vereinigten Staaten macht. Jedes verkaufte iPhone enthält dedizierte neuronale Rechenleistung.
Diese Skalierung überträgt sich nicht auf Merchant-KI-Infrastruktur, was Apples Rang begrenzt. Das Unternehmen verkauft Geräte, keine Beschleuniger, und Unternehmen, die Trainingscluster aufbauen, können Apple-Silizium nicht rackweise kaufen. Für On-Device-Inferenz im Consumer-Maßstab ist Apples Position jedoch unerreicht.
8. Meta
Meta stellt keine Chips zum Verkauf her, rangiert aber gemessen am Kapitaleinsatz unter den größten KI-Hardware-Deployern der Welt. Der erste Multi-Gigawatt-KI-Supercluster des Unternehmens, Prometheus genannt, ist für den Start im Jahr 2026 geplant. Meta hat sich verpflichtet, Hunderte Milliarden Dollar in KI-Infrastruktur zu investieren, gerichtet auf GPUs und Rechenzentrumserweiterung, die an vertraglich vereinbarte Nutzung statt an spekulative Kapazität gebunden ist.
Diese Unterscheidung ist wichtig. Metas Ausgaben folgen tatsächlichen Workloads, was das Unternehmen zu einem effektiven Co-Entwickler von KI-Hardware statt zu einem passiven Käufer macht. Im Multi-Gigawatt-Maßstab beeinflussen Metas Infrastrukturanforderungen, wie Anbieter Kühlsysteme, Netzwerke und Rack-Dichte gestalten.
Meta entwirft und betreibt seine Infrastruktur für den internen Gebrauch, weshalb es trotz seiner Ausgaben unter den Merchant-Anbietern rangiert. Die Beschaffungsentscheidungen des Unternehmens prägen den Markt, auch ohne ein Produkt zum Verkauf.
9. Groq
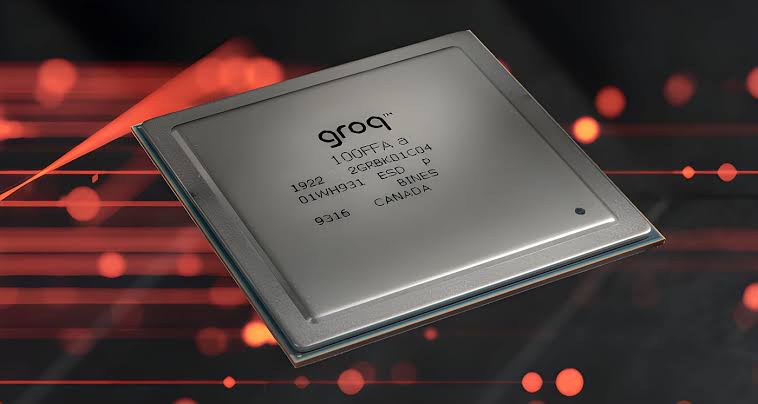
Groq war Pionier der Language Processing Unit, einer Architektur, die speziell für Echtzeit-KI-Inferenz statt für Allzweck-Training entwickelt wurde. Gründer Jonathan Ross war einer der leitenden Designer von Googles Tensor Processing Unit, und diese Expertise zeigt sich in den Designentscheidungen der LPU. Der GroqCloud-Inferenzdienst des Unternehmens ist live und für Kunden verfügbar, was Groq zu einem der wenigen KI-Chip-Startups mit einem ausgelieferten kommerziellen Produkt macht.
Die Führung änderte sich im Jahr 2026, als Adam Winter die CEO-Rolle übernahm. Der Übergang erfolgt, während Groq daran arbeitet, seine architektonische Differenzierung in Marktanteile gegenüber Hyperscaler-Silizium und NVIDIAs Inferenzangeboten umzuwandeln.
Groqs Skalierung bleibt weit unter den Unternehmen, die darüber rangieren. Eine wirklich neuartige Architektur und ein Live-Kommerzdienst verdienen dem Unternehmen einen Platz auf dieser Liste, aber der Wettbewerb mit NVIDIAs Software-Ökosystem erfordert mehr als schnellere Inferenz bei bestimmten Workloads.
10. Tenstorrent
Tenstorrent bietet die glaubwürdigste Open-Architecture-Alternative in der amerikanischen KI-Hardware. Das Unternehmen baut auf der RISC-V-Befehlssatzarchitektur auf, im Kontrast zu den proprietären Designs von NVIDIA, AMD und den Hyperscalern. Der offene Lizenzierungsansatz zielt darauf ab, Barrieren für Kunden zu senken, die anpassbare KI-Beschleuniger statt geschlossener Ökosysteme wünschen.
CEO Jim Keller leitet das Unternehmen, und sein Ruf als einer der gefeiertsten Chip-Designer der Branche verleiht Tenstorrent eine Glaubwürdigkeit, die den meisten Frühphasen-Startups fehlt. Sein Lebenslauf umfasst bedeutende Prozessorarchitekturen bei mehreren führenden Unternehmen, und diese Erfolgsbilanz zieht sowohl Talente als auch Kundeninteresse an.
Tenstorrent bleibt ein Akteur in einer früheren Phase ohne das Produktionsvolumen der Unternehmen darüber. Der Open-Source-Fokus und die RISC-V-Grundlage positionieren das Unternehmen gut, falls Kunden gegen proprietäre Bindung aufbegehren, eine Dynamik, die es bis 2027 zu beobachten gilt.
Die Top 10 der besten KI-Hardware-Hersteller in den USA 2026 teilen sich in drei unterschiedliche Gruppen. NVIDIA und AMD verkaufen Merchant-Beschleuniger auf einem offenen Markt, und ihre Produktionszeitpläne geben das Tempo für alle anderen vor. Intel, Google, Amazon, Qualcomm und Apple entwerfen Silizium primär für ihre eigenen Plattformen oder Kanäle und tauschen Marktreichweite gegen engere Hardware-Software-Integration. Groq und Tenstorrent repräsentieren die architektonischen Herausforderer, kleiner im Maßstab, aber mit wirklich unterschiedlichen Ansätzen für KI-Computing.
Related Posts
0 Comments
Join the discussion and share your thoughts
No Comments Yet
Be the first to share your thoughts on this article!