2026년 미국 최고의 AI 하드웨어 제조사 톱 10

Table of Contents
인공지능의 물리적 기반을 구축하기 위한 경쟁은 미국 제조업에서 가장 중대한 경쟁이 되었으며, 2026년 미국 최고의 AI 하드웨어 제조사 10선 순위는 권력의 균형이 얼마나 빠르게 이동했는지를 보여줍니다. NVIDIA는 2023년 초에만 해도 시가총액 1조 달러를 돌파했으며, 그 뒤를 이은 Blackwell 세대는 이전 세대보다 2.5배 빠르고 25배 더 에너지 효율적으로 작동합니다. 이러한 수치들은 자본이 왜 미국의 팹, 랙 규모 시스템, 맞춤형 실리콘 프로그램으로 계속 쏟아지는지를 설명해 줍니다.
이 목록을 작성하기 위해 우리는 매출만에 의존하지 않고 여러 요소를 저울질했습니다. 우리는 생산 상태를 살펴보았는데, 출하되는 제품이 로드맵 슬라이드보다 더 큰 비중을 차지하기 때문입니다. 우리는 공개된 고객 주문, 독립적 테스트의 벤치마크 결과, 그리고 각 회사의 소프트웨어 스택의 깊이를 조사했습니다. AI 가속기 컴퓨팅 시장 점유율도 중요했지만, 아키텍처 차별화와 제조사가 하드웨어를 공개 시장에서 판매하는지 아니면 내부적으로 소비하는지도 마찬가지로 중요했습니다. 자체 데이터 센터를 위해 칩을 설계하는 회사는 동일한 기술 역량을 갖춘 상용 벤더보다 낮은 순위에 올랐는데, 그들의 하드웨어가 제3자 구매자에게 도달하지 않기 때문입니다. 우리는 또한 2026년 출하 일정, 경영진 리더십 변화, 그리고 연중 발표된 검증 가능한 배포 규모를 고려했습니다. 그 결과는 단순한 보도자료가 아니라 실리콘을 실제 출하 제품으로 전환하는 기업에 보상을 주는 순위입니다.
2026년 미국 최고의 AI 하드웨어 제조사 10선:
1. NVIDIA
1993년에 설립되어 캘리포니아 산타클라라에 본사를 둔 NVIDIA는 업계의 거의 모든 대규모 언어 모델 훈련 실행과 추론 워크로드에 대한 기본 하드웨어 공급업체로 남아 있습니다. H100이 주도하는 Hopper 아키텍처와 B200 및 GB200을 포함한 Blackwell 라인은 연구소, 클라우드 제공업체, 기업 배포 전반에 걸쳐 표준 컴퓨팅 계층을 형성합니다.
소프트웨어 해자는 이 목록의 모든 도전자와 NVIDIA를 구분 짓는 요소입니다. 회사의 병렬 컴퓨팅 플랫폼인 CUDA는 거의 모든 AI 개발을 뒷받침하며, CUDA-X 라이브러리, NIM 마이크로서비스, 사전 훈련된 모델과 컨테이너의 NGC 카탈로그로 강화됩니다. 경쟁자들은 트랜지스터 수를 따라잡을 수 있습니다. 하지만 10년 이상 축적된 개발자 도구를 복제하는 것은 완전히 다른 문제입니다.
로드맵은 느려지지 않았습니다. Blackwell Ultra라고도 불리는 B300은 2025년 하반기에 출하되었으며, Vera Rubin NVL72 슈퍼칩은 2026년 9월에 초기 고객 접근을 시작했습니다. Vera Rubin은 맞춤형 Vera CPU와 Rubin GPU를 결합하며 2026년 말 출시를 목표로 합니다. NVIDIA는 AI 가속기 컴퓨팅의 지배적인 점유율을 보유하고 있으며, 이 목록의 다른 어떤 회사도 하드웨어 성능과 소프트웨어 종속성의 조합에서 근접하지 못합니다.
2. AMD
AMD의 Instinct MI400 시리즈는 2026년 7월 22-23일에 열린 Advancing AI 2026에서 공개되었으며, 사양은 공격적입니다. CDNA 5 기반으로 제작된 MI455X는 3,200억 개의 트랜지스터, 432GB의 HBM4 메모리, 23.3TB/s의 최대 메모리 대역폭, 40.3 PFLOPS의 OCP MXFP4 컴퓨팅 성능을 갖추고 있습니다. 이 칩은 TSMC 2nm/3nm FinFET 공정 기술로 제조되며, CDNA 4 기반의 MI355X는 이미 고객에게 출하되고 있습니다.
상업적 견인력이 AMD를 다른 모든 NVIDIA 도전자보다 높이는 요인입니다. 2026년 9월, Hewlett Packard Enterprise는 각각 72개의 MI455X GPU를 탑재한 Helios 랙에 대해 Vultr로부터 12억 달러 규모의 주문을 발표했으며, 이는 미국 데이터 센터로 향합니다. 이는 현재까지 공개된 AMD AI 가속기 배포 중 가장 큰 규모 중 하나입니다. AMD의 Helios 랙 규모 시스템은 2026년 7월에 본격 생산에 들어갔으며, 초기 출하는 2026년 3분기 말을 목표로 합니다.
AMD는 NVIDIA의 데이터 센터 로드맵을 세대별로 추적하는 출하 중인 생산 규모 GPU 라인을 갖춘 유일한 상용 벤더입니다. 회사는 여전히 소프트웨어 성숙도에서 뒤처지지만, 10억 달러 규모의 고객 주문은 하이퍼스케일러들이 구매할 것인지에 대한 질문에 답합니다.
3. Intel
Intel의 위치는 세계에서 가장 큰 레거시 x86 데이터 센터 설치 기반과 아직 따라잡고 있는 AI 가속기 로드맵에 기반합니다. 회사는 Nervana 신경망 프로세서를 단종하고 20억 달러에 인수한 Habana Labs로 전환하여 AI 전략의 중심축으로 삼았습니다. 그 결정은 Intel의 일정을 재설정하고 훈련용 실리콘에서 뒤처지게 만들었습니다.
2025년 10월에 발표되고 Xe3P 아키텍처 기반으로 제작된 Crescent Island 데이터 센터 GPU는 추론 중심 가속기로 포지셔닝됩니다. 고객 샘플링은 2026년 하반기를 목표로 하며, Intel은 이 제품의 훈련 기능을 공개하지 않았습니다. 회사는 또한 양자 컴퓨팅 발전과 고전적 처리 혁신 사이의 공생 관계를 언급하지만, 그 작업은 수익과 더 거리가 있습니다.
Intel을 3위에 유지하는 것은 유통입니다. 이 목록의 다른 어떤 회사도 AI 관련 실리콘을 이렇게 많은 기존 기업 서버 랙에 배치할 수 없습니다. Crescent Island가 추론 워크로드에서 성능을 발휘한다면, Intel은 이를 흡수할 준비가 된 채널을 갖게 됩니다. 하드웨어가 도착하기만 하면 됩니다.
4. Google
Google의 Tensor Processing Unit은 생산 중인 하이퍼스케일러 설계 AI 실리콘 중 가장 성숙한 것입니다. TPU7x로도 지정된 Ironwood 세대는 2026년 3월에 일반 공급에 도달했습니다. 이러한 맞춤형 ASIC은 에이전트 AI 시스템이 요구하는 다단계 추론 워크로드를 포함하여 전체 AI 수명 주기에 걸쳐 훈련과 추론을 모두 지원합니다.
1998년에 설립되어 Sundar Pichai CEO 아래 캘리포니아에 본사를 둔 Google은 개방형 소프트웨어 프레임워크와 함께 TPU를 공동 설계하여 칩 레이아웃부터 배포된 모델까지 기술 스택을 완전히 통제합니다. 이러한 수직 통합은 상용 실리콘 벤더들이 따라잡기 어려운 효율성 이점을 창출하는데, Google이 자체 워크로드에 맞춰 하드웨어와 소프트웨어를 함께 조정하기 때문입니다.
한계는 유통입니다. TPU는 독립형 하드웨어로 판매되기보다 주로 Google Cloud를 통해 소비되며, 이는 상용 벤더 대비 회사의 순위를 제한합니다. 그러나 이미 Google Cloud 내부에 있는 고객에게 Ironwood는 NVIDIA 의존에 대한 신뢰할 수 있는 대안을 제공합니다.
5. Amazon (AWS)
AWS는 훈련, 추론, 범용 컴퓨팅에 걸쳐 클라우드 제공업체 중 가장 완전한 수직 통합 맞춤형 실리콘 포트폴리오를 운영합니다. 2025년 12월에 출시된 Trn3 UltraServer는 144개의 Trainium3 칩을 탑재하고 Trainium2 UltraServer보다 4배 이상 뛰어난 성능을 발휘합니다. Trainium3 자체는 이전 세대보다 40% 더 에너지 효율적이며, 이 수치는 데이터 센터 전력 제약을 고려할 때 매우 중요합니다.
Graviton4 프로세서는 범용 측면을 담당합니다. 이 96코어 ARM 기반 칩은 데이터베이스, 웹 서버, 고성능 컴퓨팅 워크로드용 EC2 R8g 인스턴스를 구동하며, Graviton3 대비 3배의 vCPU와 메모리로 최대 30% 더 나은 성능을 제공합니다. Trainium3는 NeuronCore ASIC 아키텍처에서 2025년 12월에 일반 공급에 도달했습니다.
AWS는 가장 큰 클라우드 시장 점유율을 보유하고 있으며, 이는 맞춤형 칩이 대부분의 독립형 칩 제조사가 접근할 수 없는 규모로 배포된다는 것을 의미합니다. 그 내부 규모는 지속적인 개발을 지원하며, Trn3 UltraServer의 밀도 향상은 전략이 결과를 내고 있음을 보여줍니다.
6. Qualcomm
Qualcomm은 경쟁사보다 늦게 AI 데이터 센터 시장에 진입했지만, 효율성 벤치마크는 주목을 요구합니다. Cloud AI 100 칩은 공개된 테스트에서 NVIDIA H100의 108에 대해 와트당 227 서버 쿼리를 달성했으며, 객체 감지 워크로드에서 H100의 2.4에 대해 와트당 3.8 쿼리를 기록했습니다. 전력 예산이 제약이 되는 추론 배포에서 이러한 비율은 실질적인 무게를 지닙니다.
2025년 10월에 발표된 AI200 추론 가속기는 2026년 상업적 출시를 목표로 합니다. Qualcomm은 또한 근접 메모리 컴퓨팅을 사용하는 ASIC 설계를 개발 중이며, 이 아키텍처는 기존 가속기의 한계인 데이터 이동 병목을 줄입니다. 회사의 통신 및 모바일 배경은 전력 제약 실리콘 설계에 깊은 전문성을 제공하며, 이는 데이터 센터 효율성 작업으로 직접 이어집니다.
데이터 센터 입지는 여전히 초기 단계이며, Qualcomm은 AMD의 Vultr 거래에 필적하는 대규모 고객 주문을 공개하지 않았습니다. 효율성 이야기는 설득력이 있습니다. 배포 이야기는 아직 쓰이고 있습니다.
7. Apple
Apple은 여기 다른 모든 회사와 다른 길을 갑니다. 가속기를 판매하기보다는 신경 엔진을 A 시리즈 및 M 시리즈 칩에 직접 내장하여 실리콘 설계부터 운영 체제 수준의 AI 프레임워크까지 전체 스택을 통제합니다. 이러한 수직 통합을 통해 Apple은 온디바이스 처리를 위해 제3자 실리콘에 의존하지 않고 iPhone, iPad, Mac 전반에 AI 기능을 배포할 수 있습니다.
그 결과는 소비자 AI 하드웨어에서 성능과 전력 효율성에 대한 종단 간 통제입니다. Apple 실리콘은 어떤 데이터 센터 칩 제조사도 맞출 수 없는 규모로 출하되어, Apple을 미국에서 AI 지원 소비자 프로세서의 최대 물량 출하업체로 만듭니다. 판매되는 모든 iPhone은 전용 신경 컴퓨팅을 탑재합니다.
그 규모는 상용 AI 인프라로 이어지지 않으며, 이는 Apple의 순위를 제한합니다. 회사는 가속기가 아닌 기기를 판매하며, 훈련 클러스터를 구축하는 기업은 Apple 실리콘을 랙 단위로 구매할 수 없습니다. 그러나 소비자 규모의 온디바이스 추론에서는 Apple의 위치가 비할 데 없습니다.
8. Meta
Meta는 판매용 칩을 제조하지 않지만, 자본 투입 측면에서 지구상에서 가장 큰 AI 하드웨어 배포업체 중 하나입니다. Prometheus라는 이름의 회사 최초 다중 기가와트 AI 슈퍼클러스터는 2026년 출시를 계획하고 있습니다. Meta는 AI 인프라에 수천억 달러를 투자하기로 약속했으며, 이는 추측성 용량이 아닌 계약된 사용량과 연계된 GPU 및 데이터 센터 확장에 집중됩니다.
그 구분은 중요합니다. Meta의 지출은 실제 워크로드를 추적하므로, 회사는 수동적 구매자가 아닌 AI 하드웨어의 효과적인 공동 개발자가 됩니다. 다중 기가와트 규모에서 Meta의 인프라 요구 사항은 벤더가 냉각 시스템, 네트워킹, 랙 밀도를 설계하는 방식에 영향을 미칩니다.
Meta는 내부 사용을 위해 인프라를 설계하고 운영하므로, 지출에도 불구하고 상용 벤더 아래에 위치합니다. 회사의 조달 결정은 판매할 제품이 없어도 시장을 형성합니다.
9. Groq
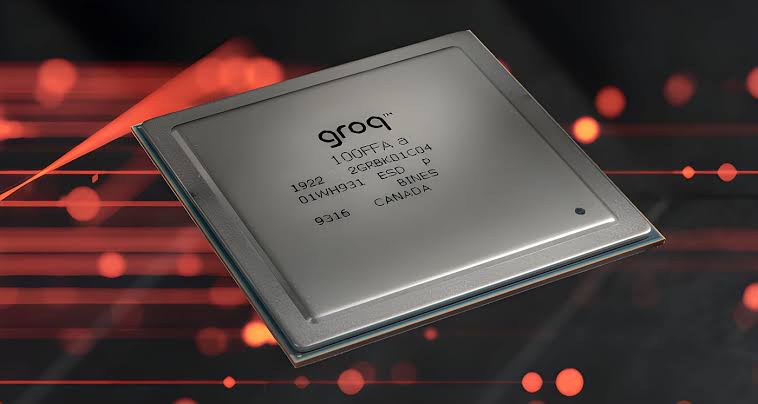
Groq는 범용 훈련이 아닌 실시간 AI 추론을 위해 특별히 구축된 아키텍처인 Language Processing Unit을 개척했습니다. 창립자 Jonathan Ross는 Google Tensor Processing Unit의 주요 설계자 중 한 명이었으며, 그 전문성은 LPU의 설계 선택에 드러납니다. 회사의 GroqCloud 추론 서비스는 라이브 상태이며 고객이 이용할 수 있어, Groq를 출하 중인 상업적 제품을 보유한 몇 안 되는 AI 칩 스타트업 중 하나로 만듭니다.
2026년에 리더십이 변경되어 Adam Winter가 CEO 역할을 맡았습니다. 이 전환은 Groq가 아키텍처 차별화를 하이퍼스케일러 실리콘 및 NVIDIA의 추론 제품에 대항하는 시장 점유율로 전환하기 위해 노력하는 가운데 이루어졌습니다.
Groq의 규모는 위에 순위된 회사들보다 훨씬 낮습니다. 진정으로 새로운 아키텍처와 라이브 상업 서비스는 회사가 이 목록에 오를 자격을 얻지만, NVIDIA의 소프트웨어 생태계와 경쟁하려면 특정 워크로드에서 더 빠른 추론 이상의 것이 필요합니다.
10. Tenstorrent
Tenstorrent는 미국 AI 하드웨어에서 가장 신뢰할 수 있는 개방형 아키텍처 대안을 제공합니다. 회사는 NVIDIA, AMD, 하이퍼스케일러의 독점 설계와 대조되는 RISC-V 명령어 집합 아키텍처를 기반으로 구축합니다. 개방형 라이선스 접근 방식은 폐쇄된 생태계보다 맞춤형 AI 가속기를 원하는 고객의 진입 장벽을 낮추는 것을 목표로 합니다.
CEO Jim Keller가 회사를 이끌고 있으며, 업계에서 가장 저명한 칩 설계자 중 한 명으로서의 그의 명성은 대부분의 초기 단계 스타트업이 부족한 신뢰성을 Tenstorrent에 부여합니다. 그의 경력은 여러 선도 기업에서 주요 프로세서 아키텍처에 걸쳐 있으며, 그 실적은 인재와 고객 관심을 모두 끌어들입니다.
Tenstorrent는 위 회사들의 생산 규모가 없는 초기 단계 플레이어로 남아 있습니다. 오픈 소스 중심과 RISC-V 기반은 고객이 독점적 종속에 반발할 경우 회사를 유리한 위치에 놓으며, 이 역학은 2027년까지 주목할 가치가 있습니다.
2026년 미국 최고의 AI 하드웨어 제조사 10선은 세 가지 뚜렷한 그룹으로 나뉩니다. NVIDIA와 AMD는 개방 시장에 상용 가속기를 판매하며, 그들의 생산 일정은 다른 모든 이들의 속도를 설정합니다. Intel, Google, Amazon, Qualcomm, Apple은 주로 자체 플랫폼이나 채널을 위해 실리콘을 설계하여 시장 도달 범위를 더 긴밀한 하드웨어-소프트웨어 통합과 교환합니다. Groq와 Tenstorrent는 규모는 작지만 AI 컴퓨팅에 대한 진정으로 다른 접근 방식을 제공하는 아키텍처 도전자들을 대표합니다.
Related Posts
0 Comments
Join the discussion and share your thoughts
No Comments Yet
Be the first to share your thoughts on this article!