أفضل 10 مصنّعين لأجهزة الذكاء الاصطناعي في الولايات المتحدة لعام 2026

Table of Contents
أصبح السباق لبناء الطبقة المادية للذكاء الاصطناعي أهم منافسة في التصنيع الأمريكي، وتعكس قائمتنا لأفضل 10 مصنّعين لمعدات الذكاء الاصطناعي في الولايات المتحدة لعام 2026 مدى السرعة التي تحوّل بها ميزان القوى. فقد تجاوزت شركة NVIDIA وحدها تقييمًا سوقيًا بقيمة تريليون دولار في أوائل عام 2023، وجيل Blackwell الذي تلاه يعمل الآن أسرع بـ2.5 مرة وأكثر كفاءة في استهلاك الطاقة بـ25 مرة من أسلافه. وتفسر هذه الأرقام سبب استمرار تدفق رؤوس الأموال إلى المصانع الأمريكية وأنظمة مراكز البيانات المتكاملة وبرامج الرقائق المخصصة.
لبناء هذه القائمة، وزنّا عدة عوامل بدلًا من الاعتماد على الإيرادات وحدها. نظرنا إلى حالة الإنتاج، لأن منتجًا يُشحن فعليًا يحمل وزنًا أكبر من خريطة طريق على شريحة عرض. وفحصنا طلبات العملاء المعلنة، ونتائج الاختبارات المعيارية من اختبارات مستقلة، وعمق حزمة البرمجيات لكل شركة. كانت الحصة السوقية في حوسبة مسرّعات الذكاء الاصطناعي مهمة، لكن التمايز المعماري أيضًا كان مهمًا، وكذلك ما إذا كان المصنّع يبيع المعدات في السوق المفتوحة أم يستهلكها داخليًا. الشركات التي تصمم رقائق لمراكز بياناتها الخاصة تحتل مرتبة أدنى من البائعين التجاريين ذوي القدرة التقنية نفسها، لأن معداتها لا تصل أبدًا إلى المشترين من الأطراف الثالثة. أخذنا في الحسبان أيضًا الجداول الزمنية للشحن في 2026، وتغييرات القيادة التنفيذية، وحجم عمليات النشر القابلة للتحقق المعلنة خلال العام. والنتيجة هي تصنيف يكافئ الشركات التي تحوّل السيليكون إلى منتج يُشحن، وليس مجرد بيانات صحفية.
أفضل 10 مصنّعين لمعدات الذكاء الاصطناعي في الولايات المتحدة لعام 2026:
1. NVIDIA
تأسست NVIDIA عام 1993 ويقع مقرها الرئيسي في سانتا كلارا بولاية كاليفورنيا، ولا تزال المورد الافتراضي للمعدات في كل عمليات تدريب النماذج اللغوية الكبيرة وأحمال الاستدلال تقريبًا في الصناعة. تشكّل معمارية Hopper الخاصة بالشركة، بقيادة H100، وخط Blackwell، بما في ذلك B200 وGB200، طبقة الحوسبة المعيارية عبر مختبرات البحث ومزودي الخدمات السحابية وعمليات النشر المؤسسية.
الخندق البرمجي هو ما يميز NVIDIA عن كل منافس في هذه القائمة. فمنصة CUDA، منصة الحوسبة المتوازية للشركة، تدعم تقريبًا كل تطوير للذكاء الاصطناعي، وتعززها مكتبات CUDA-X وخدمات NIM المصغرة وكتالوج NGC للنماذج والحاويات المدربة مسبقًا. يمكن للمنافسين مجاراة عدد الترانزستورات. أما تكرار أكثر من عقد من أدوات المطورين فهو مشكلة مختلفة تمامًا.
لم تتباطأ خريطة الطريق. فقد شُحن B300، المعروف أيضًا باسم Blackwell Ultra، في النصف الثاني من عام 2025، ودخل شريحة Vera Rubin NVL72 الفائقة مرحلة الوصول المبكر للعملاء في سبتمبر 2026. يجمع Vera Rubin بين وحدة معالجة مركزية Vera المخصصة ووحدة معالجة رسومات Rubin ويستهدف نافذة إطلاق في أواخر 2026. تمتلك NVIDIA الحصة المهيمنة في حوسبة مسرّعات الذكاء الاصطناعي، ولا تقترب أي شركة أخرى في هذه القائمة من مزيجها من أداء المعدات والارتباط البرمجي.
2. AMD
وصلت سلسلة Instinct MI400 من AMD في حدث Advancing AI 2026، الذي أُقيم في 22-23 يوليو، والمواصفات طموحة. تحمل MI455X، المبنية على CDNA 5، 320 مليار ترانزستور و432 جيجابايت من ذاكرة HBM4 و23.3 تيرابايت/ثانية من عرض النطاق الترددي الأقصى للذاكرة و40.3 بيتافلوب من حوسبة OCP MXFP4. تُصنّع الشريحة بتقنية عملية TSMC 2nm/3nm FinFET، وMI355X المبنية على CDNA 4 تُشحن بالفعل للعملاء.
الجاذبية التجارية هي ما يرفع AMD فوق كل منافس آخر لـNVIDIA. في سبتمبر 2026، أعلنت Hewlett Packard Enterprise عن طلب بقيمة 1.2 مليار دولار من Vultr لخزائن Helios، تحمل كل منها 72 وحدة معالجة رسومات MI455X، متجهة إلى مراكز بيانات أمريكية. ويُعد ذلك من بين أكبر عمليات النشر المعلنة لمسرّعات الذكاء الاصطناعي من AMD حتى الآن. دخل نظام Helios المتكامل على مستوى الخزانة من AMD الإنتاج الكامل في يوليو 2026، مع استهداف الشحنات الأولية لنهاية الربع الثالث من 2026.
AMD هي البائع التجاري الوحيد الذي يمتلك خط وحدات معالجة رسومات يُشحن فعليًا وعلى نطاق إنتاجي ويواكب خريطة طريق مراكز البيانات من NVIDIA جيلًا بجيل. لا تزال الشركة متأخرة في نضج البرمجيات، لكن طلب عميل بقيمة مليار دولار يجيب عن سؤال ما إذا كانت شركات الحوسبة الفائقة ستشتري.
3. Intel
يرتكز موقع Intel على أكبر بصمة قديمة لمعمارية x86 في مراكز البيانات حول العالم، وعلى خريطة طريق لمسرّعات الذكاء الاصطناعي لا تزال تلحق بالركب. أوقفت الشركة معالجات Nervana الشبكية العصبية وتحولت إلى Habana Labs، التي استحوذت عليها مقابل 2 مليار دولار، لتكون مرتكزًا لاستراتيجيتها في الذكاء الاصطناعي. أعاد ذلك القرار ضبط الجدول الزمني لـIntel وتركها تلاحق المنافسين في شرائح التدريب.
تُطرح وحدة معالجة الرسومات Crescent Island لمراكز البيانات، المعلنة في أكتوبر 2025 والمبنية على معمارية Xe3P، كمسرّع يركز على الاستدلال. يُستهدف توفير العينات للعملاء في النصف الثاني من 2026، ولم تكشف Intel عن قدرات التدريب لهذه القطعة. تشير الشركة أيضًا إلى علاقة تكافلية بين تقدم الحوسبة الكمومية وابتكارات المعالجة الكلاسيكية، رغم أن هذا العمل لا يزال بعيدًا عن تحقيق الإيرادات.
ما يُبقي Intel في المرتبة الثالثة هو التوزيع. لا يمكن لأي شركة أخرى في هذه القائمة وضع سيليكون قريب من الذكاء الاصطناعي في هذا العدد الكبير من خزائن الخوادم المؤسسية القائمة. إذا أدت Crescent Island أداءً جيدًا في أحمال الاستدلال، فلدى Intel قناة جاهزة لاستيعابها. على المعدات فقط أن تصل.
4. Google
تمثل وحدات معالجة التنسور (TPU) من Google أكثر سيليكون ذكاء اصطناعي ناضج في الإنتاج مصمم من قبل شركات الحوسبة الفائقة. وصل جيل Ironwood، المعروف أيضًا بـTPU7x، إلى التوفر العام في مارس 2026. تدعم هذه الدوائر المتكاملة المخصصة (ASIC) كلاً من التدريب والاستدلال عبر دورة حياة الذكاء الاصطناعي الكاملة، بما في ذلك أحمال الاستدلال متعدد الخطوات التي تتطلبها أنظمة الذكاء الاصطناعي الوكيلية.
تأسست Google عام 1998 ويقع مقرها في كاليفورنيا تحت قيادة الرئيس التنفيذي سوندار بيتشاي، وتصمم وحدات TPU بالتعاون مع أطر برمجية مفتوحة، مما يمنح الشركة سيطرة كاملة على حزمتها التقنية من تصميم الشريحة إلى النموذج المنشور. ينتج عن هذا التكامل الرأسي مكاسب في الكفاءة يصعب على بائعي السيليكون التجاريين مجاراتها، لأن Google تضبط المعدات والبرمجيات معًا وفقًا لأحمالها الخاصة.
القيد هو التوزيع. تُستهلك وحدات TPU بشكل أساسي عبر Google Cloud بدلًا من بيعها كمعدات مستقلة، مما يحد من مرتبة الشركة مقارنة بالبائعين التجاريين. لكن بالنسبة للعملاء الموجودين بالفعل داخل Google Cloud، يقدم Ironwood بديلًا موثوقًا للاعتماد على NVIDIA.
5. Amazon (AWS)
تدير AWS أكثر محفظة سيليكون مخصص متكاملة رأسيًا بين مزودي الخدمات السحابية، تشمل التدريب والاستدلال والحوسبة العامة. يضم Trn3 UltraServer، الذي أُطلق في ديسمبر 2025، 144 شريحة Trainium3 ويؤدي أداءً أفضل بأكثر من أربعة أضعاف من خوادم Trainium2 UltraServers. وTrainium3 نفسه أكثر كفاءة في استهلاك الطاقة بنسبة 40 بالمئة من الأجيال السابقة، وهو رقم بالغ الأهمية نظرًا لقيود الطاقة في مراكز البيانات.
يغطي معالج Graviton4 الجانب العام. تعمل هذه الشريحة ذات 96 نواة المبنية على ARM على تشغيل مثيلات EC2 R8g لقواعد البيانات وخوادم الويب وأحمال الحوسبة عالية الأداء، وتوفر أداءً أفضل بنسبة تصل إلى 30 بالمئة مع ثلاثة أضعاف وحدات المعالجة الافتراضية والذاكرة مقارنة بـGraviton3. وصل Trainium3 إلى التوفر العام في ديسمبر 2025 على معمارية NeuronCore ASIC.
تمتلك AWS أكبر حصة في السوق السحابية، مما يعني أن رقائقها المخصصة تُنشر بأحجام لا تستطيع معظم شركات تصنيع الرقائق المستقلة الاقتراب منها. يمول هذا الحجم الداخلي التطوير المستمر، وتُظهر مكاسب الكثافة في Trn3 UltraServer أن الاستراتيجية تحقق نتائج.
6. Qualcomm
دخلت Qualcomm سوق مراكز بيانات الذكاء الاصطناعي في وقت متأخر عن منافسيها، لكن معايير الكفاءة لديها تستدعي الانتباه. حققت شريحة Cloud AI 100 نتيجة 227 استعلامًا لكل واط مقابل 108 لـNVIDIA H100 في اختبارات منشورة، و3.8 استعلام لكل واط مقابل 2.4 لـH100 في أحمال كشف الأجسام. بالنسبة لعمليات نشر الاستدلال حيث تكون ميزانيات الطاقة مقيّدة، تحمل هذه النسب وزنًا حقيقيًا.
يستهدف مسرّع الاستدلال AI200، المعلن في أكتوبر 2025، التوفر التجاري في 2026. وتطور Qualcomm أيضًا تصميم ASIC يستخدم الحوسبة القريبة من الذاكرة، وهي معمارية تقلل عنق الزجاجة في حركة البيانات الذي يحد من المسرّعات التقليدية. تمنح خلفية الشركة في الاتصالات والهواتف المحمولة خبرة عميقة في تصميم السيليكون المقيّد بالطاقة، وهو ما يترجم مباشرة إلى العمل على كفاءة مراكز البيانات.
لا يزال الحضور في مراكز البيانات في مرحلة مبكرة، ولم تكشف Qualcomm عن طلبات عملاء كبيرة مماثلة لصفقة Vultr مع AMD. قصة الكفاءة مقنعة. أما قصة النشر فلا تزال قيد الكتابة.
7. Apple
تسلك Apple مسارًا مختلفًا عن كل شركة أخرى هنا. فبدلًا من بيع المسرّعات، تدمج محركات عصبية مباشرة في رقائق سلسلة A وسلسلة M، وتتحكم في الحزمة الكاملة من تصميم السيليكون إلى أطر الذكاء الاصطناعي على مستوى نظام التشغيل. يتيح هذا التكامل الرأسي لـApple نشر ميزات الذكاء الاصطناعي عبر iPhone وiPad وMac دون الاعتماد على سيليكون طرف ثالث للمعالجة على الجهاز.
النتيجة هي سيطرة شاملة على الأداء وكفاءة الطاقة في معدات الذكاء الاصطناعي الاستهلاكية. تُشحن شرائح Apple بأحجام لا يجاريها أي مصنّع رقائق لمراكز البيانات، مما يجعل Apple أكبر شاحن من حيث الحجم لمعالجات القادرة على الذكاء الاصطناعي الاستهلاكية في الولايات المتحدة. كل iPhone يُباع يحمل حوسبة عصبية مخصصة.
هذا الحجم لا يترجم إلى بنية تحتية تجارية للذكاء الاصطناعي، مما يحد من مرتبة Apple. تبيع الشركة أجهزة وليس مسرّعات، ولا يمكن للمؤسسات التي تبني عناقيد تدريب شراء سيليكون Apple بالخزانة. لكن بالنسبة للاستدلال على الجهاز على نطاق استهلاكي، فإن موقع Apple لا يُضاهى.
8. Meta
لا تصنّع Meta رقائق للبيع، لكنها تُصنّف بين أكبر ناشري معدات الذكاء الاصطناعي على وجه الأرض من حيث الالتزام الرأسمالي. من المقرر إطلاق أول عنقود فائق للذكاء الاصطناعي متعدد الجيجاواط، المسمى Prometheus، في 2026. التزمت Meta باستثمار مئات مليارات الدولارات في البنية التحتية للذكاء الاصطناعي، موجهة إلى وحدات معالجة الرسومات وتوسيع مراكز البيانات المرتبط بالاستخدام المتعاقد عليه بدلًا من القدرة التخمينية.
هذا التمييز مهم. يتتبع إنفاق Meta أحمال العمل الفعلية، مما يجعل الشركة مطورًا مشاركًا فعّالًا لمعدات الذكاء الاصطناعي بدلًا من مشترٍ سلبي. على نطاق متعدد الجيجاواط، تؤثر متطلبات Meta للبنية التحتية على كيفية تصميم البائعين لأنظمة التبريد والشبكات وكثافة الخزائن.
تصمم Meta بنيتها التحتية وتشغلها للاستخدام الداخلي، ولهذا تحتل مرتبة أدنى من البائعين التجاريين رغم إنفاقها. تشكّل قرارات الشراء لدى الشركة السوق حتى دون وجود منتج للبيع.
9. Groq
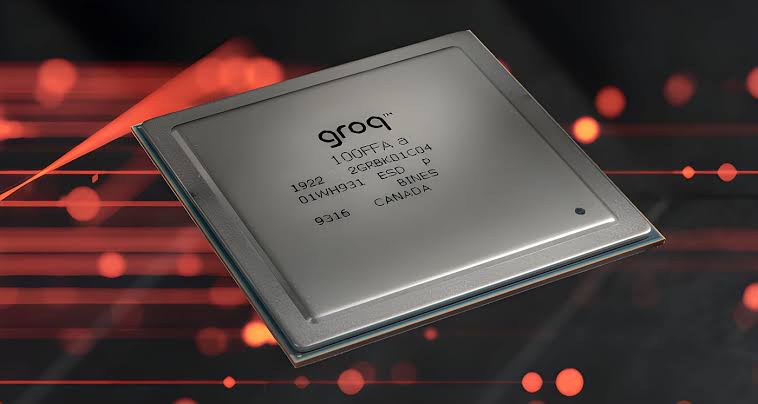
كانت Groq رائدة في وحدة معالجة اللغة (LPU)، وهي معمارية مبنية خصيصًا للاستدلال الفوري في الذكاء الاصطناعي بدلًا من التدريب العام. كان المؤسس جوناثان روس أحد المصممين الرئيسيين لوحدة معالجة التنسور من Google، وتظهر تلك الخبرة في خيارات تصميم LPU. خدمة الاستدلال GroqCloud الخاصة بالشركة متاحة وتعمل للعملاء، مما يجعل Groq واحدة من الشركات الناشئة القليلة في رقائق الذكاء الاصطناعي التي لديها منتج تجاري يُشحن.
تغيّرت القيادة في 2026، حيث تولى آدم وينتر منصب الرئيس التنفيذي. يأتي هذا الانتقال بينما تعمل Groq على تحويل تمايزها المعماري إلى حصة سوقية ضد سيليكون شركات الحوسبة الفائقة وعروض الاستدلال من NVIDIA.
لا يزال حجم Groq أقل بكثير من الشركات المصنفة فوقها. معمارية مبتكرة حقًا وخدمة تجارية عاملة يمنحان الشركة مكانًا في هذه القائمة، لكن المنافسة مع النظام البيئي البرمجي لـNVIDIA تتطلب أكثر من استدلال أسرع في أحمال عمل محددة.
10. Tenstorrent
تقدم Tenstorrent البديل الأكثر مصداقية للمعمارية المفتوحة في معدات الذكاء الاصطناعي الأمريكية. تبني الشركة على مجموعة تعليمات RISC-V، على النقيض من التصاميم الاحتكارية لـNVIDIA وAMD وشركات الحوسبة الفائقة. يهدف نهج الترخيص المفتوح لديها إلى خفض الحواجز أمام العملاء الذين يريدون مسرّعات ذكاء اصطناعي قابلة للتخصيص بدلًا من أنظمة بيئية مقفلة.
يقود الشركة الرئيس التنفيذي جيم كيلر، وسمعته كواحد من أشهر مصممي الرقائق في الصناعة تمنح Tenstorrent مصداقية تفتقر إليها معظم الشركات الناشئة في مراحلها المبكرة. تمتد سيرته الذاتية عبر معماريات معالجات رئيسية في عدة شركات رائدة، وهذا السجل يجذب المواهب واهتمام العملاء على حد سواء.
لا تزال Tenstorrent لاعبًا في مرحلة مبكرة دون حجم الإنتاج الذي تتمتع به الشركات المذكورة أعلاه. يضع التركيز على المصادر المفتوحة وأساس RISC-V الشركة في موقع جيد إذا دفع العملاء ضد الارتباط الاحتكاري، وهو ديناميكية تستحق المتابعة خلال 2027.
تنقسم قائمة أفضل 10 مصنّعين لمعدات الذكاء الاصطناعي في الولايات المتحدة لعام 2026 إلى ثلاث مجموعات متمايزة. تبيع NVIDIA وAMD مسرّعات تجارية في سوق مفتوحة، وجداولهما الزمنية للإنتاج تحدد وتيرة الجميع. تصمم Intel وGoogle وAmazon وQualcomm وApple السيليكون بشكل أساسي لمنصاتها أو قنواتها الخاصة، مقايضة الوصول إلى السوق بتكامل أكثر إحكامًا بين المعدات والبرمجيات. تمثل Groq وTenstorrent المنافسين المعماريين، أصغر حجمًا لكنهما يقدمان نهجًا مختلفًا حقًا لحوسبة الذكاء الاصطناعي.
Related Posts
0 Comments
Join the discussion and share your thoughts
No Comments Yet
Be the first to share your thoughts on this article!